此笔记记录学习书本 强化学习(第2版)作者: 【加】Richard S. Sutton(理查德·桑顿) / 【美】Andrew G. Barto(安德鲁·巴图) 著的学习与总结笔记,其中部分内容由AI生成。
三种方法对比总结
| 方法 | 更新方式 | 适用场景 | 是否需要环境模型 | 计算量 | 收敛速度 |
|---|---|---|---|---|---|
| 蒙特卡洛 | 只有回合结束后更新 | 适用于无模型、离线学习 | 不需要 | 高 | 慢 |
| 时序差分(TD) | 每一步都更新 | 适用于无模型、在线学习 | 不需要 | 低 | 快 |
| 动态规划(DP) | 通过转移概率计算更新 | 适用于已知环境 | 需要 | 低 | 快 |
- 蒙特卡洛(MC):必须 等待回合结束 才能更新,不适用于实时学习。
- 时序差分(TD):每一步都更新,比蒙特卡洛更快,适用于 在线学习。
- 动态规划(DP):需要 环境模型(转移概率),但计算最精确,适用于 已知环境。
在强化学习中,TD 学习是最常用的,因为它既能在线更新,又不依赖于环境模型。蒙特卡洛主要用于 离线学习,而动态规划适用于 已知环境(如象棋等确定性环境)。
同轨策略 vs. 离轨策略
| 同轨策略(On-policy) | 离轨策略(Off-policy) | |
|---|---|---|
| 数据来源 | 当前策略 | 其他策略 |
| 更新的策略 | 使用同一个策略更新 | 使用不同策略更新 |
| 典型算法 | SARSA、Actor-Critic、REINFORCE | Q-learning、DQN |
| 探索方式 | 需要手动引入探索(如 ε-贪心) | 训练目标本身包含最优策略 |
| 收敛速度 | 相对较慢 | 相对较快 |
- 同轨策略(On-policy) 更像是一个人在 边学边做,不断根据自己的经验来调整行为。
- 离轨策略(Off-policy) 更像是一个人 看着别人的经验 来学习,并且能更快收敛到最优解。
| 方法 | 更新公式 | 说明 |
|---|---|---|
| TD(0) | $ V(s_t) \leftarrow V(s_t) + \alpha \left[ r_t + \gamma V(s_{t+1}) - V(s_t) \right] $ | 通过当前状态的价值和下一个状态的价值来更新,估计状态的价值。仅依赖下一个状态的值来进行更新,适用于 状态价值估计。 |
| SARSA | $ Q(s_t, a_t) \leftarrow Q(s_t, a_t) + \alpha \left[ r_t + \gamma Q(s_{t+1}, a_{t+1}) - Q(s_t, a_t) \right] $ | 使用当前策略进行学习,依赖于当前的动作选择,当前状态和动作以及下一个状态和动作共同更新 Q 值,适用于 策略学习。 |
| Q-learning | $ Q(s_t, a_t) \leftarrow Q(s_t, a_t) + \alpha \left[ r_t + \gamma \max_a Q(s_{t+1}, a) - Q(s_t, a_t) \right] $ | 通过选择最大 Q 值的动作进行学习,无论当前策略如何,只关心未来的最佳动作,适用于 最优策略学习。 |
| TD(λ) | $ Q(s_t, a_t) \leftarrow Q(s_t, a_t) + \alpha \left[ r_t + \gamma \sum_{i=0}^{\infty} \lambda^i \delta_i - Q(s_t, a_t) \right] $ | 结合了 TD(0) 和蒙特卡洛方法,回溯多步更新,适用于长期学习,特别是在复杂任务中,考虑到 多步未来的反馈。 |
为什么SARSA进行的是策略学习而非状态价值估计?
-
动作价值函数(( Q(s, a) ))的学习:
SARSA的目标是学习动作价值函数 ( Q(s, a) ),而不是单独学习状态价值函数 ( V(s) )。这是因为在强化学习中,我们关心的通常是在某个状态下采取某个动作后能获得的回报,而不仅仅是状态本身的“价值”。动作价值函数能够直接反映在某个状态下采取特定动作的好坏。 -
SARSA是基于策略的学习:
SARSA算法通过采取当前策略下的动作,并根据当前策略的行为来估计未来的回报。这意味着,SARSA本质上是在同轨策略下学习,并通过当前策略来选择动作。因此,它不仅关注状态本身,而是通过状态-动作对(( s_t, a_t ))来进行学习。- 在每个时间步,SARSA都会通过当前策略选择动作(比如 ( \epsilon )-贪婪策略),然后更新相应的 ( Q(s, a) )。
- 而对于状态价值函数(( V(s) )),它只是通过所有可能动作的加权平均来得到的,因此,如果我们只学习状态价值而不学习动作价值,我们就无法通过具体的动作决策来直接优化策略。
-
策略学习与状态价值的关系:
状态价值函数 ( V(s) ) 只能在策略已知的情况下计算,而在SARSA中,策略本身是通过持续更新的动作价值函数来间接优化的。SARSA不直接估计状态价值函数,而是通过( Q(s, a) )来间接影响策略的改进。 -
为什么动作价值比状态价值更有意义?:
在强化学习中,我们的目标通常是最大化回报,而回报的最大化依赖于在每个状态下选择合适的动作。学习状态价值只是帮助我们知道一个状态本身的好坏,但我们仍然需要知道在每个状态下应该采取什么样的动作来优化回报。这就是为什么SARSA(以及其他基于值的策略学习算法)会直接学习动作价值函数。- 在策略迭代或值迭代中,策略是通过状态值函数来更新的,但SARSA通过动作值函数来优化策略,因为动作选择比状态值更直接影响回报。
SARSA与状态价值估计的关系
尽管SARSA本身不直接估计状态价值函数 ( V(s) ),但通过学习动作价值函数(( Q(s, a) )),我们可以间接地得到状态价值函数 ( V(s) )。实际上,状态价值函数可以通过对所有可能动作的加权平均来计算:
$
$
$$ 其中,\( \pi(a|s) \) 是在状态 \( s \) 下采取动作 \( a \) 的概率。通过这种方式,尽管SARSA不直接估计状态价值函数,但它间接提供了可以计算状态价值函数的所有信息。 $$总结:
SARSA算法专注于学习动作价值函数(( Q(s, a) )),而不是直接估计状态价值函数 ( V(s) )。这是因为在强化学习中,目标是优化策略,通过学习每个状态-动作对的价值来选择最佳动作。SARSA通过直接估计每个状态下的动作价值,而不是仅仅估计状态本身的价值,从而能够更有效地学习和改进策略。
常用 TD 方法的区别
| 方法 | 策略类型 | 更新方式 | 目标 | 适用场景 |
|---|---|---|---|---|
| TD(0) | 同轨 | 仅依赖当前状态的价值和下一个状态的价值进行更新 | 估计状态价值函数 | 在线实时学习,适用于估计状态值 |
| SARSA | 同轨 | 当前动作和下一个动作共同更新 Q 值 | 学习当前策略的 Q 值 | 行为安全,如机器人、自动驾驶 |
| Q-learning | 离轨 | 最大化下一个状态的 Q 值进行更新 | 学习最优策略的 Q 值 | 追求最优策略,游戏、围棋 AI |
| TD(λ) | 同轨 | 结合 TD(0) 和蒙特卡洛方法,回溯多步更新 | 估计状态-动作值函数 | 长期学习,适用于复杂任务 |
对比说明:
- TD(0):只考虑一个时间步的更新,适用于简单的状态价值估计。
- SARSA:基于当前策略,更新状态-动作值 Q(s, a),适用于在线学习和行为安全。
- Q-learning:选择未来最大 Q 值的动作更新状态-动作值,适用于追求最优策略。
- TD(λ):通过多个时间步回溯来更新,结合了 TD(0) 和蒙特卡洛方法,适用于 长期学习和 复杂任务。
Dyna-Q 算法家族是基于强化学习中 将真实经验与模型模拟经验结合 的一类算法。它们融合了模型学习(Model-based)与价值函数更新(如 Q-learning),具有较高的样本效率。
以下是 Dyna-Q 及其常见变体的对比表格,包括其核心思路、改进点、是否探索模型变化等关键特征。
Dyna-Q 及其主要变体对比表
| 算法名称 | 核心思想 | 是否使用模型 | 是否增强探索 | 是否处理非定常环境 | 优点 | 缺点 |
|---|---|---|---|---|---|---|
| Dyna-Q | 基础版本,将 Q-learning 与模拟经验结合 | ✅ 有 | ❌ 否 | ❌ 否 | 学习效率高、结构简单 | 模型质量差时可能误导学习 |
| Dyna-Q+ | 在模型中加入“探索奖励”,鼓励模拟冷门状态-动作对 | ✅ 有 | ✅ 是 | ✅ 是 | 增强探索能力、适应非定常性 | 增加超参数(探索奖励函数) |
| Prioritized Dyna-Q | 使用优先级队列优先更新影响大的状态 | ✅ 有 | ✅ 是 | ❌ 否 | 更高效率、优先更新重要经验 | 实现复杂度稍高 |
| Dyna-2 | 在模型中使用多个估计模型进行模拟(不确定建模) | ✅ 多模型 | ✅ 是 | ✅ 是 | 对不确定性建模,有利于探索与适应 | 存储和计算量大 |
| Dyna-Q with Linear Function Approximation | 使用线性函数逼近代替 Q 表 | ✅ 有 | ❌ 否 | ✅ 视模型 | 可扩展到大状态空间 | 精度依赖函数逼近器质量 |
| Dyna-Q with Neural Networks | 用神经网络逼近 Q 值和环境模型 | ✅ 有 | ✅ 是 | ✅ 是 | 可用于连续空间、复杂环境 | 容易不稳定,需要技巧调参 |
1. Dyna-Q
- 基础版本,结合真实交互 + 模拟经验。
- 每次从模型中随机选择过往 (s, a),进行“虚拟更新”。
2. Dyna-Q+
- 解决 Dyna-Q 早期探索不足的问题。
- 给模型中长时间未访问的 (s, a) 加一个额外奖励:
$
$$ \text{bonus} = k \cdot \sqrt{\tau} $$$
其中 τ 是未访问的时间步数,k 是超参数。
3. Prioritized Dyna-Q
- 模拟更新不再随机,而是基于“状态更新的重要性”进行排序更新(如 TD 误差越大,越优先)。
- 使用优先队列实现,更高效。
4. Dyna-2
- 使用多个不同的模型(表示环境可能的变化),每次模拟时从这些模型中采样。
- 更适合非定常或不确定环境(如博弈、对手变换等)。
5. 函数逼近版本(线性 / 神经网络)
- 替代表格型 Q 值,用函数逼近器(如神经网络)逼近 Q 值或环境动态。
- 适用于大规模/连续状态空间的环境。
总结推荐(不同需求)
| 使用场景 | 推荐算法 |
|---|---|
| 小型离散环境 | Dyna-Q / Dyna-Q+ |
| 希望强化探索、避免早收敛 | Dyna-Q+ |
| 数据有限,希望学习快 | Prioritized Dyna-Q |
| 非定常环境(如对手策略变化) | Dyna-Q+ 或 Dyna-2 |
| 状态空间较大 / 连续 | 函数逼近版 Dyna-Q |
| 有强大计算资源+深度学习 | Dyna-Q with Neural Networks |
第一部分总结
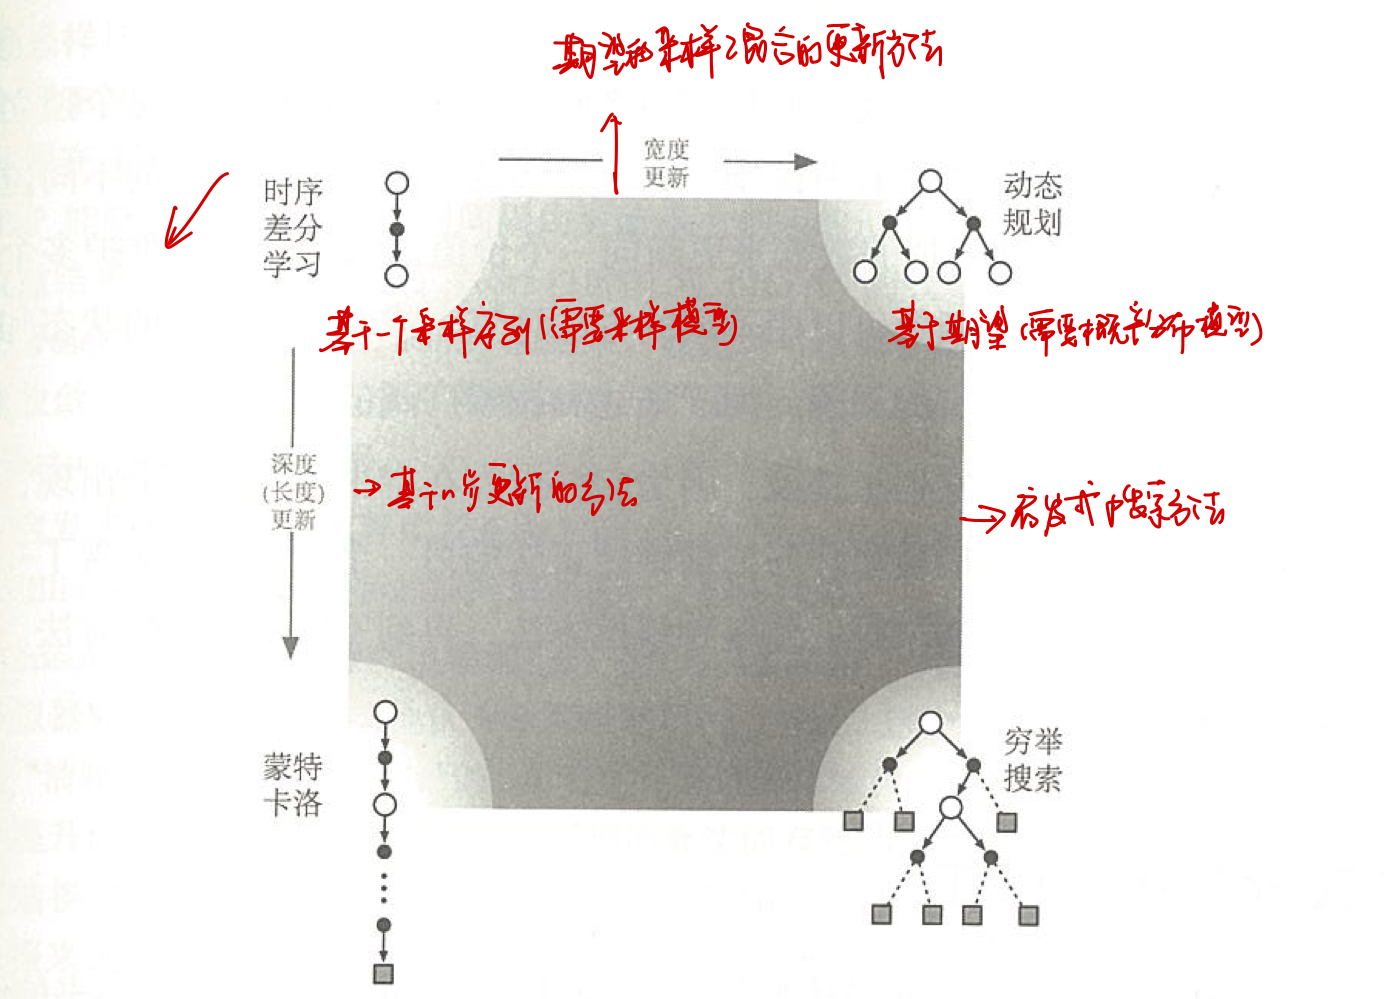
在强化学习中,**时间差分(TD)**方法、**动态规划(DP)方法和蒙特卡洛(MC)**方法是三种常见的策略评估和优化技术。每种方法都有其适用的场景,并且它们的优缺点也有所不同。下面是对这三种方法的简要概述,以及它们分别适合的场景。
| 方法 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| TD(时间差分) | 在线学习、实时学习、大规模状态空间、部分可观察的环境 | 能够在线更新,适合实时学习,计算效率高 | 收敛慢,对初始值敏感,可能产生偏差 |
| DP(动态规划) | 已知完整环境模型、离线学习、有限状态空间 | 能找到最优策略和最优值函数,理论精确 | 需要完整的环境模型,不适用于大规模状态空间 |
| MC(蒙特卡洛) | 完全可观察的环境、回合结束后更新、离线学习 | 不需要环境模型,只需回报进行更新,适合复杂环境 | 需要等待回合结束,不适合在线学习,计算低效(尤其状态空间大时) |
在强化学习中,基于函数逼近的同轨策略预测(On-Policy Prediction with Function Approximation)是指在使用函数逼近来估计值函数时,采用与当前策略相同的轨迹来进行学习。这种方法通常是为了处理大规模或连续的状态空间,其中使用表格型方法来表示值函数变得不再可行。
1. 同轨策略(On-Policy):
- 同轨策略意味着学习过程中使用的策略(通常是行为策略)和用于估计状态值函数的策略是相同的。在这种方法中,智能体根据当前策略与环境进行交互并收集经验,而使用这些经验来更新策略的值函数。
2. 函数逼近(Function Approximation):
- 函数逼近是为了处理大规模状态空间(或者连续空间),通过使用参数化函数(如线性函数、神经网络等)来逼近值函数(如状态值函数 ( V(s) ) 或动作值函数 ( Q(s, a) )),避免使用表格形式存储所有可能的状态或动作。
- 函数逼近可以帮助将值函数从一个巨大的状态空间简化为一个相对较小的参数空间,从而能够在更大的环境中进行有效的学习。
3. 同轨策略预测的内容:
在基于函数逼近的同轨策略预测中,主要包括以下几个方面:
1. 使用TD(时间差分)方法进行同轨策略预测:
-
同轨策略预测的经典方法是使用TD方法,例如TD(0),在这种方法中,值函数是通过逐步更新的。
-
通过TD(0) 或 SARSA(基于同轨策略的TD方法),智能体根据其当前策略进行状态转移并计算每一步的回报。随着时间的推移,智能体不断根据回报对其值函数进行更新。
典型的更新公式为:
$
$
其中:
- ( s_t ) 是当前状态,
- ( r_{t+1} ) 是当前奖励,
- ( V(s_{t+1}) ) 是下一个状态的估计值,
- ( \gamma ) 是折扣因子,
- ( \alpha ) 是学习率。
2. 线性函数逼近:
- 在使用线性函数逼近时,值函数 ( V(s) ) 被表示为状态特征的线性组合:
$
$
$$ 其中 \( \theta \) 是参数向量,\( \phi(s) \) 是状态 \( s \) 的特征向量。 $$- 通过梯度下降或其他优化方法,智能体学习合适的参数 ( \theta ) 来逼近状态的值函数。
3. 非线性函数逼近(例如神经网络):
- 对于更加复杂的任务,尤其是当状态空间非常大且不容易用线性函数表示时,可以使用神经网络作为函数逼近器。神经网络可以通过多层结构捕捉状态和价值之间的复杂关系。
- **深度Q网络(DQN)**是一个经典的例子,它使用深度神经网络来逼近动作值函数 ( Q(s, a) ),并通过同轨策略进行学习。
4. 策略评估和更新:
- 在基于函数逼近的同轨策略预测中,智能体不断评估当前策略的表现并使用TD方法更新其值函数。同时,策略也会基于这些估计进行调整,以改善智能体的表现。
5. 基于梯度的更新:
- 对于非线性逼近(如神经网络),值函数的更新通常通过梯度下降进行。智能体根据策略评估的结果(即对状态值函数或动作值函数的估计),通过反向传播算法来更新函数逼近器的参数。
4. 同轨策略预测的经典算法:
以下是一些常见的使用函数逼近的同轨策略预测算法:
(1) SARSA(λ):
- SARSA(λ) 是一种结合了时间差分学习(TD)和跟踪误差的算法,使用λ-回溯来进行更长期的估计。
- 使用类似于TD(0)的更新规则,但通过加权历史的TD误差来改进更新过程,从而获得更快的收敛。
(2) 深度Q学习(DQN):
- DQN 是一种结合了Q-learning和深度神经网络的方法,使用神经网络逼近动作值函数 ( Q(s, a) )。
- 在DQN中,策略是基于贪心策略(即选择最大Q值的动作),并且通过训练神经网络来更新Q值。
(3) A3C(异步优势演员-评论家):
- A3C 是一种基于策略梯度的强化学习算法,使用两个网络(演员和评论家)来估计策略和状态值函数。A3C采用了多线程训练,在多个环境中同时训练,来提高学习效率。
5. 优缺点分析:
优点:
- 大规模问题:基于函数逼近的方法可以处理大规模或连续的状态空间,不需要每个状态都保存一个值。
- 适用动态环境:与表格型方法不同,基于函数逼近的方法可以在动态和复杂的环境中工作。
- 灵活性:可以使用线性和非线性函数逼近(如神经网络),提供了更大的灵活性来应对各种环境。
缺点:
- 收敛性问题:当使用非线性函数逼近时(例如神经网络),可能会面临不稳定性和收敛性问题。
- 过拟合:如果模型过于复杂,可能会过拟合训练数据,导致泛化能力差。
- 需要大量计算:使用深度学习等方法时,计算成本和训练时间可能非常高。
总结:
基于函数逼近的同轨策略预测利用当前策略下的经验来更新值函数或策略,适用于大规模或连续的状态空间,并使用函数逼近(如线性函数或神经网络)来解决表格型方法无法处理的问题。常见的算法包括SARSA(λ)、DQN和A3C等。
| 对比维度 | TD(0)(时序差分) | LSTD(最小二乘TD) |
|---|---|---|
| 方法类型 | 增量式更新算法 | 批量方法 / 解线性方程组 |
| 是否使用采样 | 是 | 是 |
| 是否使用bootstrapping | 是 | 是 |
| 收敛速度 | 慢,需多次遍历 | 快,一次遍历即可 |
| 收敛稳定性 | 对学习率敏感,较不稳定 | 稳定性高 |
| 是否需要学习率(α) | 是 | 否 |
| 是否需要存储所有数据 | 否(可在线更新) | 是(需存储一批数据计算矩阵) |
| 估计误差类型 | 噪声大,估计不准确 | 最小化TD误差平方,估计精确 |
| 函数逼近类型 | 支持线性与非线性 | 仅适用于线性函数逼近 |
| 计算代价 | 低(每步更新) | 高(求解矩阵逆) |
| 是否可在线使用 | 是 | 否(需收集一批样本) |
| 是否适合大规模状态空间 | 是 | 否(矩阵求逆开销大,维度高时困难) |
| 常见用途 | 在线学习、环境交互 | 批量预测、策略评估 |
| 结果可解释性 | 随机性大,结果随步长波动 | 更平滑、可解释性好 |
总结推荐:
- TD(0):适合在线学习、环境交互、资源有限时使用。算法简单,适合实时任务。
- LSTD:适合批量数据分析、预测任务,或者需要快速稳定收敛的场景,但计算复杂度高,适合线性逼近小维度问题。
第九章:基于函数逼近的同轨策略预测
核心背景:为什么要函数逼近?
如果希望强化学习系统能够应用于人工智能和大型工程应用中,则系统必须有能力进行泛化。
强化学习传统方法(比如表格型 Q-learning)依赖于将每个状态或状态-动作对显式地存储在表格中。当状态空间很大或是连续的时候(比如自动驾驶、围棋、股票市场),这种方法就无法胜任了。
因此我们需要函数逼近器(function approximator),来对价值函数进行泛化,比如:
- 线性模型
- 多项式函数
- 神经网络(即深度学习)
- RBF(径向基函数)
- 瓦片编码(tile coding)
核心思想:用监督学习方法逼近值函数
只要将每次更新时涉及的二元组
(s → g)作为训练样本就可以了。
在强化学习中,我们在每一步都可以得到一个样本:
1 | state s → 目标值 g |
其中目标值 g 可能是:
- 蒙特卡洛返回:
G = r1 + r2 + ... + rn - TD 返回:
r + γ * V(s')
这些“输入→目标值”本质上和监督学习里的训练对没什么不同。
所以我们可以借用监督学习的工具(比如神经网络训练)来拟合这个过程。
💡 什么是同轨策略(on-policy)?
我们定义均方价值误差 VE(w) 为对使用权值向量 w 的近似价值函数
v̂_w(s)的加权误差。
在强化学习中,同轨策略是指:
- 使用的策略 π 既用于生成数据(交互环境),又用于评估/学习。
相比之下,异轨策略 off-policy(比如 Q-learning)是指用一个行为策略采样,但学习的是另一个目标策略。
VE(w) 衡量的是:近似函数 v̂_w(s) 相对于真实状态值 v_π(s) 的误差,通常定义为:
1 | VE(w) = ∑ μ(s) * (v̂_w(s) - v_π(s))² |
其中 μ(s) 是状态的访问概率(stationary distribution)。
📉 如何优化这个误差?
最常见的方法是随机梯度下降(SGD)及其变种
我们希望通过调整参数 w 来让 VE(w) 尽可能小:
1 | w ← w - α * ∇VE(w) |
但问题是,我们不知道 v_π(s) 的真实值,所以不能直接计算 ∇VE(w)。
于是我们使用TD目标或蒙特卡洛目标来估计误差,从而构造所谓的半梯度算法(semi-gradient methods)。
🧮 什么是“半梯度方法”?为什么叫这个名?
在这种自举法(如DP)中,权值向量在更新目标中出现,但计算梯度时不考虑它
“半梯度”意思是:你在 TD 学习中更新的目标 r + γ * v̂_w(s') 是带有 w 的,但你却不对这个目标求梯度。你只对 v̂_w(s) 这一部分求梯度。
示例:
1 | delta = r + γ * v̂_w(s') - v̂_w(s) # TD误差 |
注意:目标中有 v̂_w(s'),但我们更新时不对它求导,所以叫“半梯度”。
🔢 线性函数逼近(最重要的一个基类)
线性函数逼近中,值估计是特征加权求和:
v̂(s) = φ(s)^T w
这是强化学习中最容易分析和收敛性最好的逼近方式。
φ(s)是状态的特征向量(比如 one-hot 编码、瓦片编码、RBF等)w是权值向量(参数)- 优点:分析简单,收敛性好,计算快
🎨 特征选择的策略?
选择好的特征是加先验知识的一种重要方式
特征越好,泛化效果越好。
- 多项式特征(如
1, x, x²)通常不太适合RL - 傅立叶基:适合周期性问题(比如控制摆动)
- 瓦片编码(Tile coding):非常适合离散近似连续空间,计算快
- 径向基函数(RBF):适用于平滑响应的低维问题
📚 不同方法对比
| 方法 | 描述 | 数据效率 | 计算复杂度 |
|---|---|---|---|
| 半梯度 TD(0) | 单步更新,自举 | 中等 | O(d) |
| n步TD | 使用 n 步回报 | 高 | O(d) |
| 蒙特卡洛(MC) | 用整幕回报更新 | 高 | O(d) |
| LSTD | 最数据高效,最精确 | 高 | O(d²) |
| 非线性逼近(NN) | 深度RL,适合复杂任务 | 取决于模型 | 高 |
d:权值数量(特征维度)
🚀 深度强化学习:非线性逼近
用神经网络表示价值函数或策略,常见于 DQN、Actor-Critic 等方法。
训练方法:
- 使用反向传播算法
- 通常使用经验回放 + 目标网络等机制
✅ 总结核心点
- 大状态空间 → 必须使用函数逼近
- 同轨策略 → 策略评估任务中,常用半梯度方法
- 线性函数逼近 → 理论最清晰、收敛性最强
- 特征选择 → 是模型性能的核心关键
- 深度强化学习 → 实现非线性逼近,适用于复杂任务
第十一章
强化学习(Reinforcement Learning, RL)中,**预测(Prediction)和控制(Control)**是两个核心任务。
一、预测算法(Prediction)
✅ 目标:
在给定策略 π 下,估计状态价值函数 v(s) 或 动作价值函数 q(s,a)。
即:不改变策略,仅预测它的长期收益。
🔧 常见算法:
1. 蒙特卡洛方法(Monte Carlo)
- 特点:基于完整episode的回报计算。
- 算法:
- 每次经历一个完整的episode后更新。
- 一般有首次访问和每次访问两种方式。
- 优点:收敛性强。
- 缺点:需要完整轨迹,不适合持续型任务。
2. 时序差分方法(Temporal Difference, TD)
- 典型代表:TD(0)
- 特点:在每一步进行更新,结合了DP和MC的优点。
- 更新公式:
3. n 步 TD
- 将 MC 与 TD 做平衡。
- 融合了更多未来信息,n 越大越接近 MC。
4. λ回报方法(TD(λ), Eligibility Traces)
- 融合了不同步长 TD。
- 使用资格迹(Eligibility Traces)追踪状态出现的痕迹,更新时考虑多个状态。
5. LSTD(Least Squares TD)
- 基于线性逼近的高效预测方法。
- 数据效率高,适合小规模线性问题。
6. 半梯度方法(Semi-gradient TD)
- 用于函数逼近时的预测算法。
- 应用于:线性函数逼近、神经网络等。
🧭 二、控制算法(Control)
✅ 目标:
通过不断与环境交互,学出最优策略 π*,从而最大化累积奖励。
🔧 常见算法:
1. 基于价值的方法(Value-based)
- 使用 Q-learning、SARSA 等估计 q(s, a),然后从中导出策略。
| 算法 | 策略类型 | 特点 |
|---|---|---|
| Q-learning | 离策略 | 目标值使用最大 q 值,更新稳定 |
| SARSA | 同策略 | 目标值来自当前实际动作,学习更平滑 |
| Expected SARSA | 同策略 | 使用期望而非最大 q 值,减少方差 |
2. 基于策略的方法(Policy-based)
- 直接优化策略 π(a|s),不通过 q。
- 常见算法:
- REINFORCE(蒙特卡洛型策略梯度)
- Actor-Critic(结合值函数和策略函数)
3. 基于值+策略的方法(Actor-Critic)
- Actor:生成策略。
- Critic:评价策略(估计价值)。
- 优点:兼顾稳定性和泛化能力。
4. 深度强化学习方法(Deep RL)
- DQN(Deep Q-Network):Q-learning + CNN。
- A3C/A2C、PPO、DDPG、SAC 等:更适合连续动作空间或复杂环境。
5. 层次化强化学习(HRL)
- 将任务分解为子任务,每个子任务有独立策略。
- 提升泛化性和解决复杂任务的能力。
三、预测 vs 控制 总结对比
| 项目 | 预测(Prediction) | 控制(Control) |
|---|---|---|
| 目标 | 给定策略,估计值函数 | 找到最优策略,最大化长期回报 |
| 是否改策略 | ❌ 不改变 | ✅ 不断优化 |
| 应用 | 策略评估、策略改进、辅助监督学习等 | 自动驾驶、交易、博弈、机器人控制等 |
| 举例 | TD(0), MC, TD(λ), LSTD | Q-learning, SARSA, PPO, DDPG等 |
策略梯度方法(Policy Gradient)和基于动作价值的方法(Value-based)是强化学习中两大主流控制类算法,它们有着本质的区别。下面从核心原理、表达方式、优化方式、优劣点等方面来做详细对比,并举例说明。
一、核心区别概述
| 对比项 | 策略梯度方法(Policy-based) | 动作价值方法(Value-based) |
|---|---|---|
| 优化目标 | 直接优化策略 π(a | s) |
| 输出 | 一个概率分布 π(a | s)(即策略) |
| 动作选择 | 采样或贪心采样策略 | 通常是选最大 Q 值的动作 |
| 适合任务 | 连续动作空间、策略需要随机性 | 离散动作空间 |
| 示例算法 | REINFORCE、PPO、A3C、TRPO | DQN、DDPG(混合型)、Q-learning |
二、数学表达差异
✅ 策略梯度方法
- 直接学习策略函数 πθ(a|s),θ 是可学习的参数。
- 优化目标是期望回报:
$
$$ J(\theta) = \mathbb{E}_{\pi_\theta} [R] $$$
- 使用策略梯度定理求梯度更新:
$
$$ \nabla_\theta J(\theta) = \mathbb{E}_{s,a \sim \pi_\theta} [\nabla_\theta \log \pi_\theta(a|s) \cdot Q^\pi(s,a)] $$$
✅ 动作价值方法
- 学习一个值函数 Q(s, a),利用贝尔曼方程:
$
$$ Q(s,a) = \mathbb{E}[r + \gamma \max_{a'} Q(s', a') | s, a] $$$
- 最终策略为贪婪策略:
$
$$ \pi(s) = \arg\max_a Q(s,a) $$$
🧪 三、优缺点对比
| 特性 | 策略梯度方法 | 动作价值方法 |
|---|---|---|
| 可处理连续动作空间 | ✅ 非常适合 | ❌ 不适用(Q值最大化不好做) |
| 可学习随机策略 | ✅(天生支持) | ❌(除非加噪声) |
| 收敛稳定性 | ✅ 稳定(TRPO/PPO) | ❌ 容易发散(如DQN) |
| 样本效率 | ❌ 低 | ✅ 高(可重用样本) |
| 实现复杂性 | 中等偏高(如PPO) | 相对较低(DQN较成熟) |
| 学习信号方差 | ❌ 高 | ✅ 低 |
📘 四、常见算法对照
| 类型 | 算法名称 | 简介 |
|---|---|---|
| Policy-based | REINFORCE | 基础策略梯度方法 |
| Policy-based | PPO(主流) | 使用信赖域防止策略更新过大 |
| Value-based | DQN | 深度Q网络,适合离散动作 |
| Hybrid(Actor-Critic) | A3C / DDPG | 同时学习策略和价值(兼顾两者) |
📌 五、实际应用区别
| 应用场景 | 建议方法 |
|---|---|
| 自动驾驶、机械臂 | 策略梯度方法(如PPO,DDPG) |
| 玩Atari游戏、围棋 | 动作价值方法(DQN,AlphaGo Zero) |
| 金融交易、投资 | 混合方法或策略梯度更优 |
| 聊天机器人策略 | 策略梯度更灵活 |
✨ 六、一个简单比喻
- Value-based方法像是在地图上学习每个地点到终点的最佳路线(Q值),然后选择路径;
- Policy-based方法像是直接学习一个“导航员”,每走一步都告诉你该怎么走(策略函数)。
TD类算法是value-based方法的一种;
policy-based 中核心公式的推导过程
你提到的这个公式是 策略梯度定理(Policy Gradient Theorem) 的核心表达式,用于直接优化策略,属于策略优化方法(Policy-based)的理论基础。我们来一步步推导它,看看它是如何来的。
目标函数定义
我们希望最大化策略的期望回报:
$
$$ J(\theta) = \mathbb{E}_{\tau \sim \pi_\theta} \left[ R(\tau) \right] $$$
其中:
- ( \pi_\theta ) 是由参数 ( \theta ) 定义的策略;
- ( \tau ) 表示一个完整的轨迹(trajectory):( \tau = (s_0, a_0, s_1, a_1, …, s_T) );
- ( R(\tau) ) 是轨迹的总回报(可以是 ( \sum_t \gamma^t r_t ))。
第一步:将期望展开为积分
我们先将目标函数写成关于轨迹概率分布的积分形式:
$
$$ J(\theta) = \int_\tau P(\tau; \theta) R(\tau) \, d\tau $$$
第二步:对 ( \theta ) 求导
$$ 对参数 \( \theta \) 求梯度: $$$
$$ \nabla_\theta J(\theta) = \int_\tau \nabla_\theta P(\tau; \theta) R(\tau) \, d\tau $$$
接下来用 对数技巧(likelihood trick):
$
$$ \nabla_\theta P(\tau; \theta) = P(\tau; \theta) \nabla_\theta \log P(\tau; \theta) $$$
于是变成:
$
$$ \nabla_\theta J(\theta) = \int_\tau P(\tau; \theta) \nabla_\theta \log P(\tau; \theta) R(\tau) \, d\tau = \mathbb{E}_{\tau \sim \pi_\theta} \left[ \nabla_\theta \log P(\tau; \theta) R(\tau) \right] $$$
第三步:轨迹的概率分解
轨迹的概率可以写成状态转移和策略乘积的形式:
$
$$ P(\tau; \theta) = \rho(s_0) \prod_{t=0}^{T-1} \pi_\theta(a_t|s_t) P(s_{t+1}|s_t, a_t) $$$
其中,环境转移概率 ( P(s_{t+1}|s_t, a_t) ) 与策略无关,因此求导时不影响,只剩下对策略部分求导:
$
$$ \log P(\tau; \theta) = \sum_{t=0}^{T-1} \log \pi_\theta(a_t | s_t) $$$
于是:
$
$$ \nabla_\theta J(\theta) = \mathbb{E}_{\tau \sim \pi_\theta} \left[ \left( \sum_{t=0}^{T-1} \nabla_\theta \log \pi_\theta(a_t | s_t) \right) R(\tau) \right] $$$
第四步:引入状态分布与动作值函数
假设我们只用时间 ( t ) 的动作做一次更新,可以写成:
$
$$ \nabla_\theta J(\theta) = \mathbb{E}_{s \sim d^\pi, a \sim \pi_\theta} \left[ \nabla_\theta \log \pi_\theta(a|s) Q^\pi(s, a) \right] $$$
这就是:
$
$$ \boxed{ \nabla_\theta J(\theta) = \mathbb{E}_{s \sim d^\pi, a \sim \pi_\theta} \left[ \nabla_\theta \log \pi_\theta(a|s) \cdot Q^\pi(s, a) \right] $$}
$
✅ 总结:
这个公式说明:
- 我们可以用策略对数的梯度乘以当前策略下的动作价值,来更新策略参数;
- 即使不知 ( Q^\pi(s,a) ),也可以用 sample-based 的方式估计它(如使用 REINFORCE 或 Actor-Critic);
- 它是策略优化的核心理论。
🔍 强化学习三大类方法对比表
| 特征维度 | Value-based | Policy-based | Model-based |
|---|---|---|---|
| 🔧 核心目标 | 估计状态或动作的价值函数 ( V(s) ), ( Q(s, a) ) | 直接优化策略 ( \pi_\theta(a | s) ) |
| 📈 优化方式 | 基于值函数最大化返回 | 基于策略梯度方法更新策略 | 使用环境模型进行模拟、规划与策略优化 |
| 🔄 是否显式建模环境 | ❌ 不建模环境 | ❌ 不建模环境 | ✅ 是,建模状态转移概率和奖励函数 |
| 🧮 常见方法 | Q-learning, DQN, Double DQN, SARSA | REINFORCE, PPO, A2C, TRPO | Dyna-Q, MBPO, PETS, Dreamer 等 |
| 🧠 策略表示 | 隐式:从 Q 值中导出策略(如 ε-greedy) | 显式:策略网络直接输出动作概率 | 显式或隐式策略;可结合 Value/Policy 方法 |
| 📉 稳定性 | 容易不稳定或发散(目标估计来自近似值) | 稳定性更高(目标明确) | 难度大但潜力强(模型误差影响策略) |
| 🧩 样本效率 | 一般较差(需大量交互) | 一般 | 较高,可使用模拟环境反复利用数据 |
| ⏱️ 计算开销 | 相对低 | 中等 | 高,需要训练模型并执行模拟 |
| 🚀 适用场景 | 离散动作、低维度任务 | 连续动作、高维策略优化 | 长远推理、高数据效率要求(如机器人控制) |